AI 项目最容易卡在哪?先看这三处断点
 KuWork
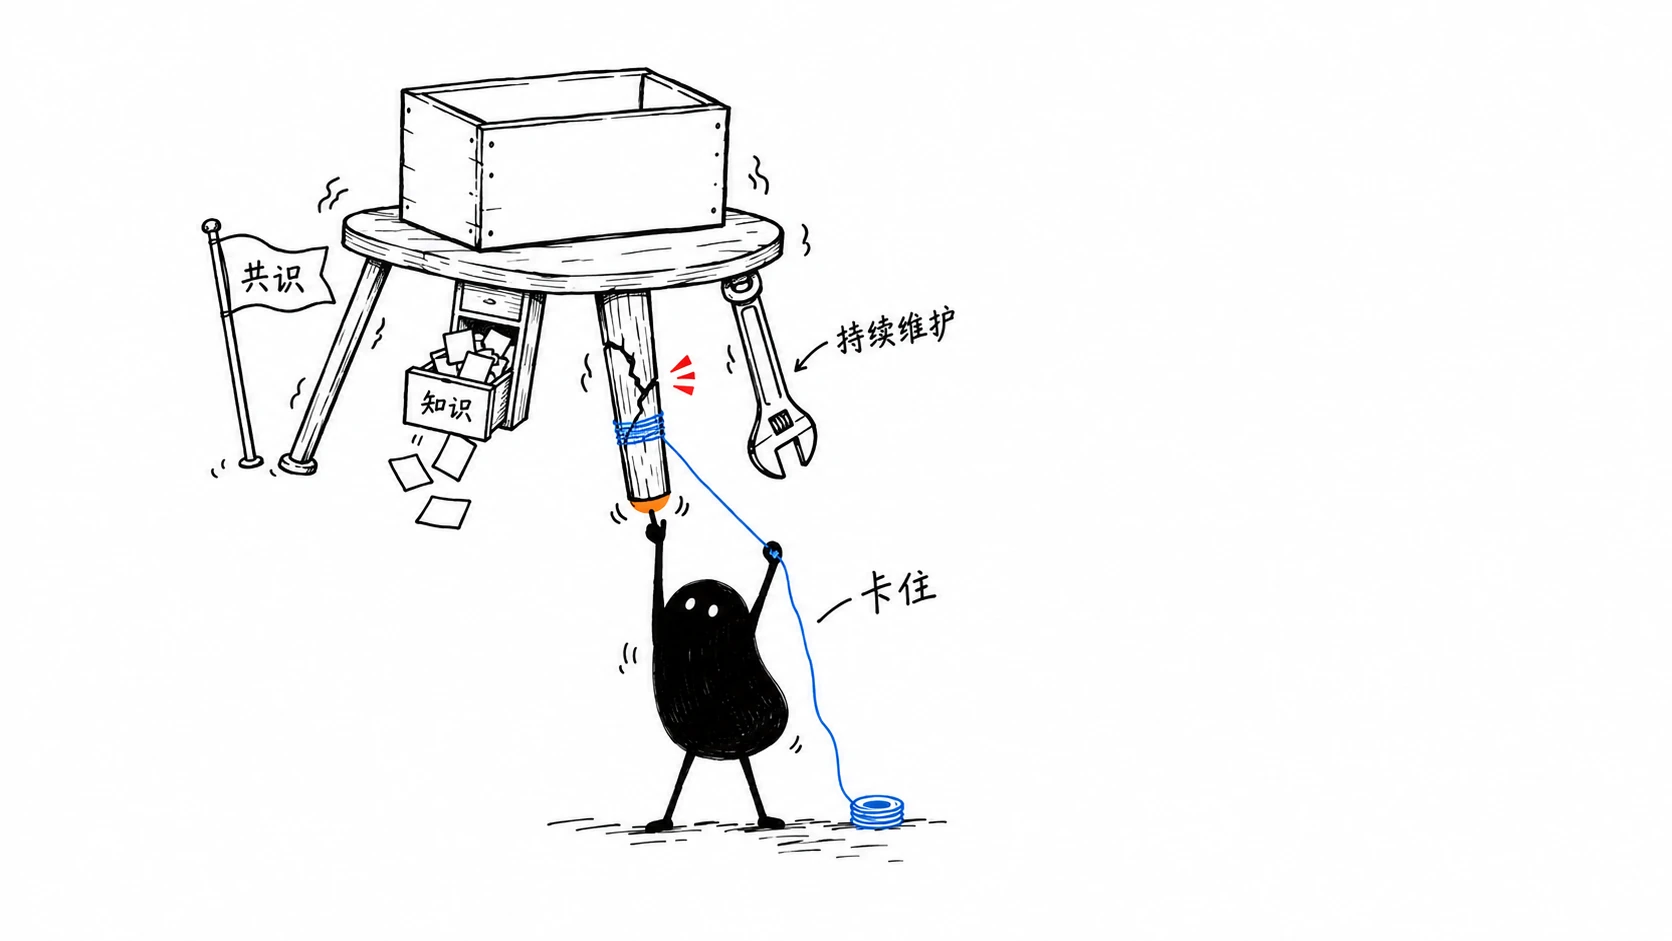
不少 AI 项目在演示时很顺,在真实工作里却停住。问题常常不在“模型够不够聪明”,而在任务、资料和责任三件事没有同时站稳:任务说不清,资料接不上,出了偏差又没人知道谁该处理。
这三件事里,只要有一件悬着,项目就很难从演示走到日常使用。
断点一:任务只写成了功能愿望
“做一个智能助手”“让 AI 帮团队提效”都还谈不上可验收的任务。要往下推进,得说清使用者在哪个节点卡住,AI 准备什么结果,人工在哪一步审核,什么变化才算改善。
如果任务定义不清,项目组很容易在“功能很多”和“业务没感觉”之间来回拉扯。
想知道任务够不够清楚,先试着写一句完整的话:“谁在什么时候,基于哪些输入,让 AI 准备什么结果,最后由谁按什么标准确认。”这句话写不出来,团队讨论的多半还是功能愿望。
断点二:资料存在,但无法安全地用
真实工作需要上下文,而上下文往往散在文档、表格、聊天和个人经验里。资料本身是否准确、是否过期、哪些人可访问、引用时如何追溯,这些问题不处理,AI 即使给出流畅答案,也很难被放心用于决策或对外内容。
资料治理不必从建一个完美知识库开始。先为试点任务整理少量权威材料,标出来源、更新时间和可用范围;边使用,边发现缺口。
资料放在那里,并不表示它能直接拿来用。过期的价格表、没有上下文的会议记录、权限范围说不清的客户信息,都可能让一份流畅回答无法采用。先圈出一小批权威材料,比让 AI 从所有历史文件里猜答案更稳妥。
断点三:AI 做了动作,责任没有落点
越接近真实流程,越要区分“系统建议”和“人负责的决定”。谁审核、谁批准、遇到异常如何回退、哪些动作不能自动执行,都要在上线前写清。否则,团队会在风险面前把 AI 退回到只能演示的状态。
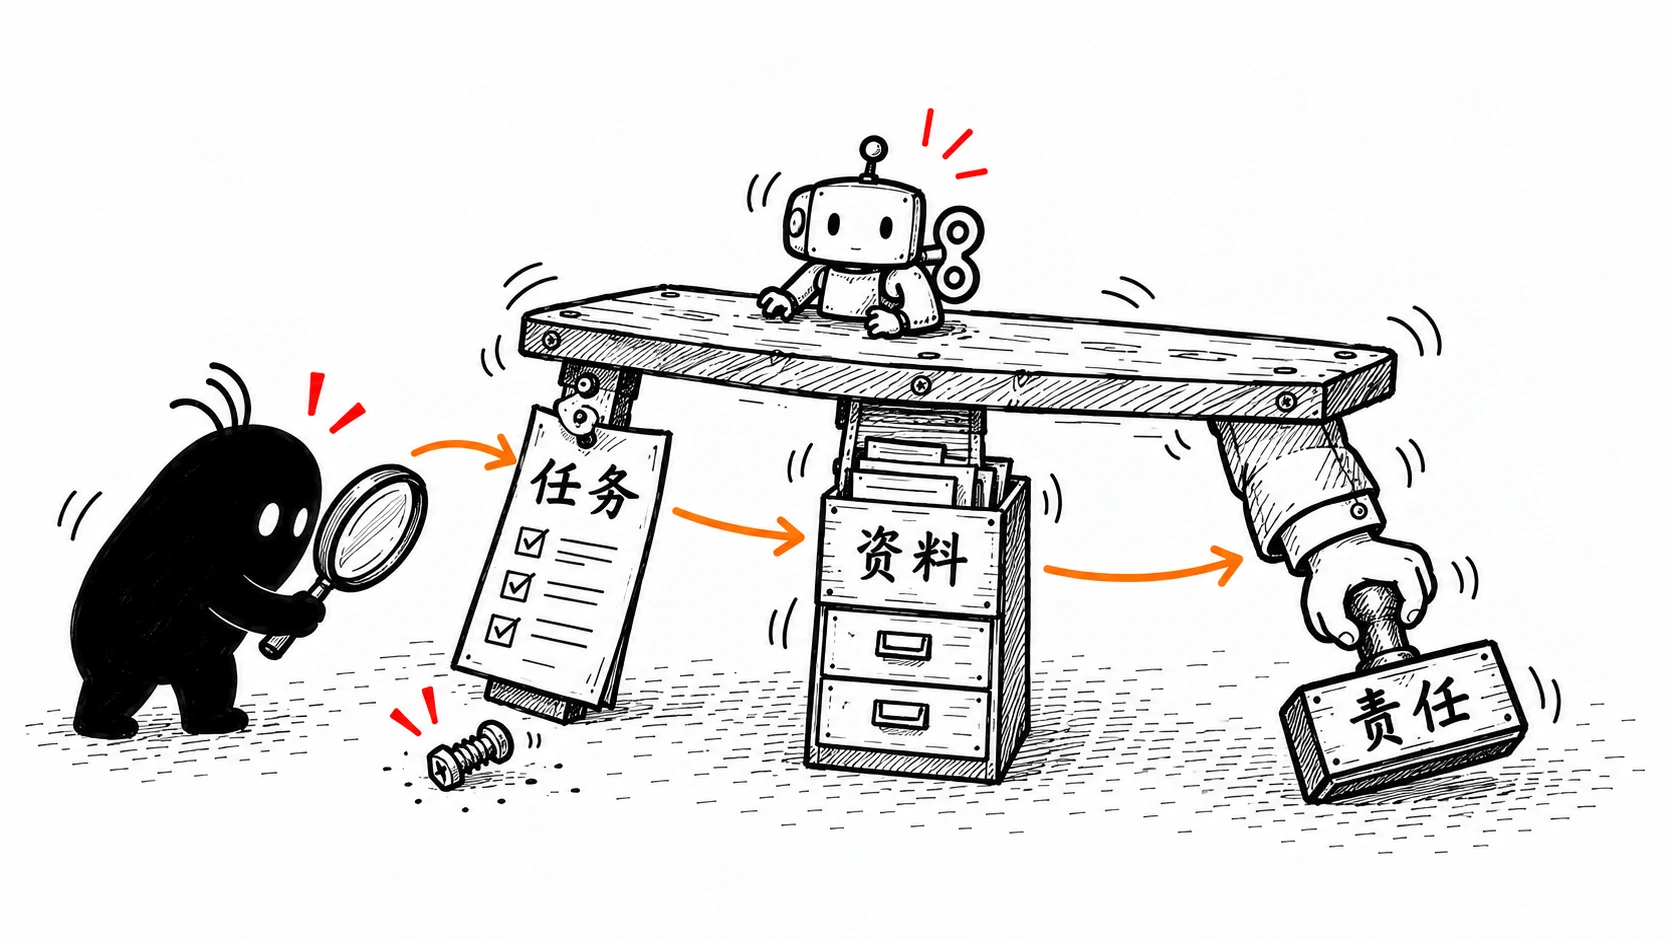
这三处断点会彼此牵连。任务不清,资料收集就没有边界;资料不可用,审核人也没法判断结果;责任不明,异常发生后没人接。排查时从最具体的任务开始,往往比先争论模型能力更快。
能跑通 Demo 的,是一次回答;能进入工作流的,是一套可交接、可校验、可回退的机制。
一个排查顺序
遇到项目停滞时,先不要急着换模型。按顺序检查:任务是否有明确输入和验收?资料是否有来源与权限边界?输出是否有人审核并承担结果?三项中哪一项空着,就先补哪一项。
在 KuWork 中把三处边界写进工作方式
KuWork 可在项目中保留任务上下文和资料,并支持人工补充、确认及查看任务推进过程。若把它用于试点,建议把三类信息分别写明:本次任务的输入与验收、可使用资料及其来源、负责人和异常时的处理方式。需要连接业务系统、读取或写入数据、设置定时自动化时,不能假定所有动作都已开放;应按当前版本、授权范围与具体异常机制核对。
这不要求“先治理、什么都不做”。低风险任务可以轻量跑起来,不过资料边界、审核人和回退办法要在开始前写明。
常见问题
能力演示很好,业务方却不愿用,先改哪里?
先回到一个业务方愿意承担的具体任务,陪它跑完一次完整闭环,再决定需要补什么能力。
治理会不会让试点太慢?
治理应与风险匹配。低风险内部试点可以轻量,但资料范围、审核人和回退办法仍应事先明确。
今天就能开始的动作
拿一个已经停住的 AI 项目,不要先列新功能。请项目负责人各写一行:本次任务的输入和验收、可用资料及来源、出现偏差后谁处理。哪一行写不完整,就从那里开始补。