企业上 AI,到底从哪一步开始?
 KuWork
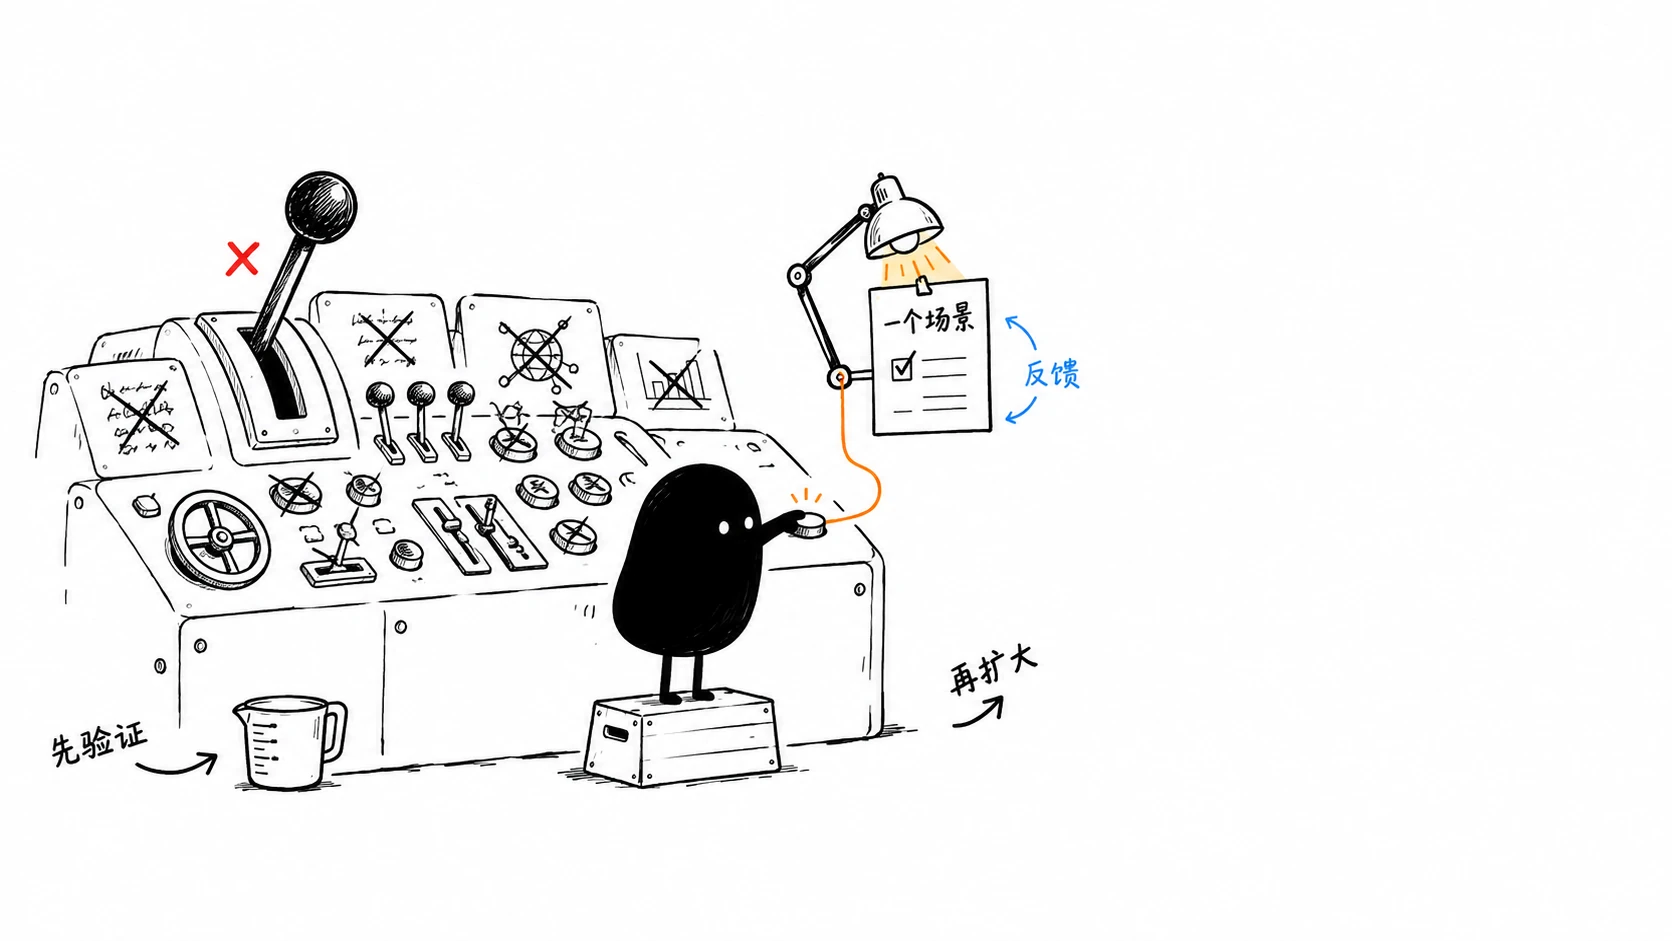
企业开始用 AI,先别急着采购一套“全能平台”。找一个真实、重复、边界清楚的工作问题,跑出一个看得见的试点。它能不能让现有工作少走一步,跑完才知道;之后再谈扩大范围。
这一步小一点没关系,关键是能把问题看明白。
为什么一上来做“大而全”容易失速
大项目看起来更有战略感,却同时叠加了太多不确定性:业务目标没有拆开、资料能否使用不清楚、流程没有负责人、效果也没有衡量口径。最后即使工具上线,也很难说清它究竟解决了什么。
更稳妥的起点,是找一段高频工作:例如会议后的行动项整理、同类材料的初步归纳、固定格式的项目交接准备。它应当满足三个条件:有人持续在做、输入和输出大致清楚、结果可以被复核。
还有一个很现实的条件:试点负责人得愿意一起改工作方式。没人愿意确认输入、检查结果或处理异常,工具再合适也只能停在演示。开始前先说清楚:人负责什么,AI 帮在哪儿,出问题后怎么回到人工。
试点前先回答五个问题
- 问题是什么? 描述当前耗时、卡点和受影响的人,而不是先描述想买的工具。
- 谁负责? 业务负责人、使用者、审核者和技术支持各自承担什么。
- 能用哪些资料? 明确可用范围、敏感信息和脱敏方式。
- 怎样算有效? 例如减少补问、缩短首稿时间、提升交接完整度;不要只看调用次数。
- 无效怎么办? 设定试点周期、退出条件和复盘时间,避免投入无限延长。
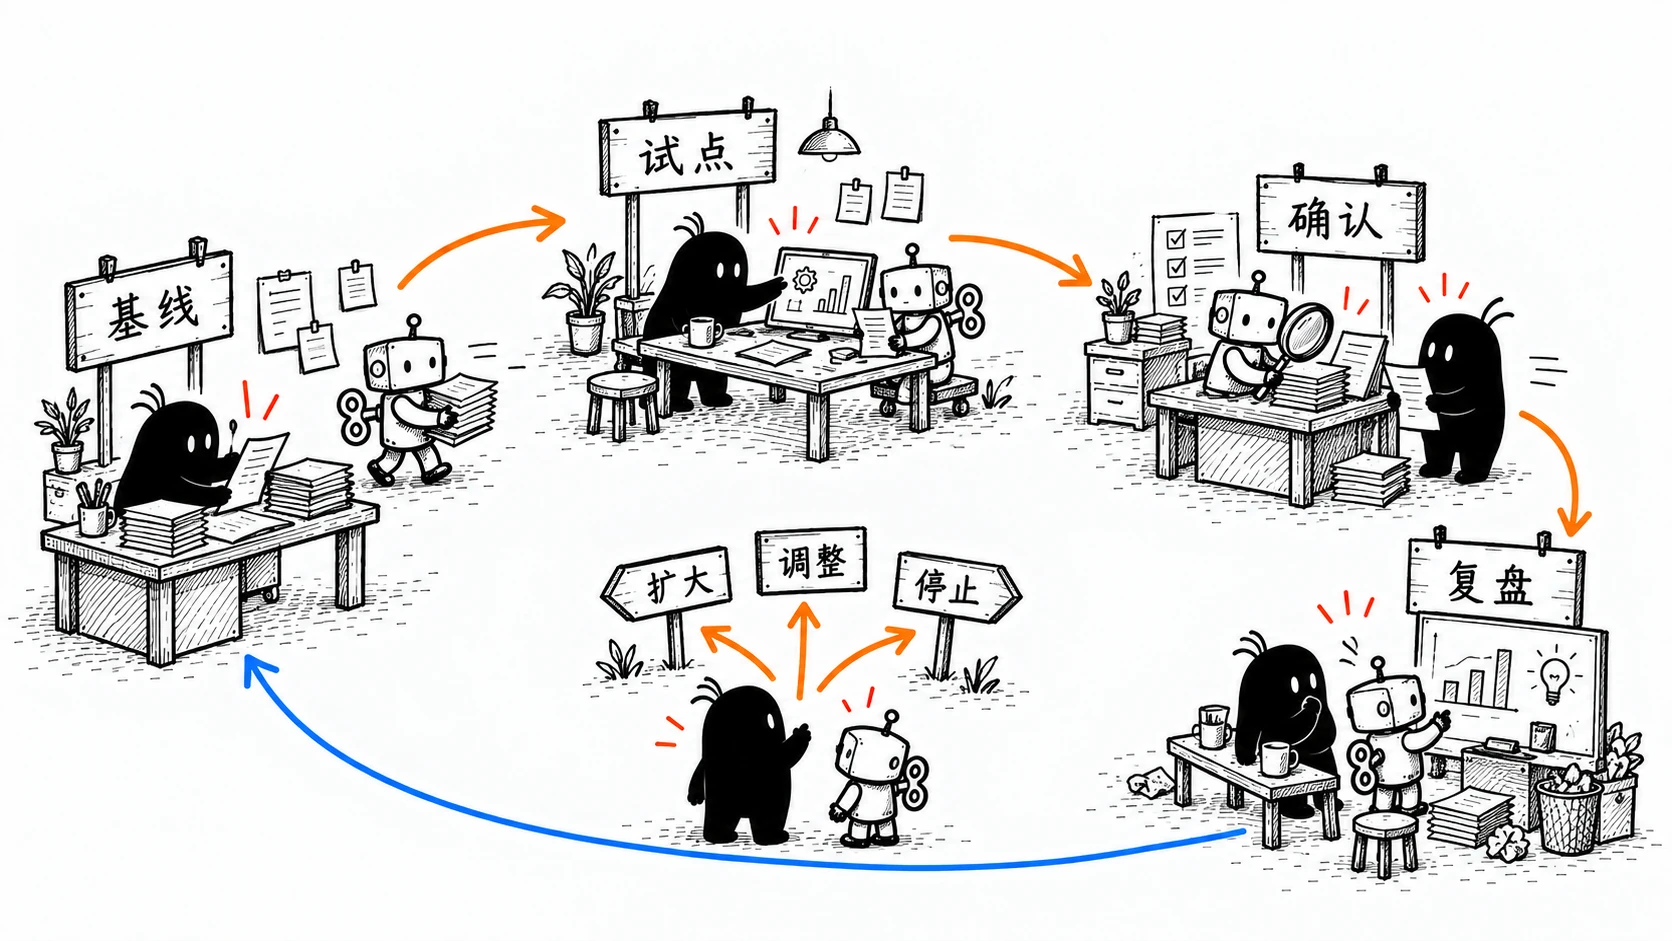
这张图里的顺序别跳。先留一份原有做法的基线,才知道后面有没有改善;运行中放进人工确认,才能及时发现不适用的地方;最后再决定扩大、调整还是停止。一个试点跑通了,也不代表可以原样复制到所有部门。每扩大一次,都要重新检查资料范围、权限和责任分工。
把试点当作一次工作流设计
别把试点理解成让几个人“多用用看”。把原来的流程、AI 介入的位置、人工审核点和最终责任人画出来,问题究竟出在模型、资料、任务定义还是协作机制,才看得出来。
用 KuWork 验证一段真实工作
KuWork 可用于在项目中组织目标、资料、任务和成果,并支持由 Ku 伙伴参与调研、分析、写作等准备工作。对试点而言,可以先选择一个低风险、结果可复核的环节:将任务背景和允许使用的资料限定在项目内,由负责人检查输出并记录异常;若工作需要连接其他系统、自动执行或对外发布,再单独确认当前连接器、读写权限和人工确认机制。
团队最终要拿到一份能说清楚的判断:什么条件下,哪一类工作少了补问、搬运或等待;哪些条件还会带来风险或返工。节省多少,应等试点跑完再看。
AI 试点要落在一段能闭环的工作上,而不是停在一个账号上。
一段工作跑顺后,再复制到相近场景;每扩大一步,都重新确认资料、权限和衡量口径是否还适用。
常见问题
试点要从最简单的任务开始吗?
不一定最简单,但要足够真实。只有真实任务才会暴露资料、审核和协作的问题。
管理层希望马上看到成果怎么办?
把目标改成可在短周期验证的工作结果,并同步说明暂不外推的边界。可验证的小结果,比无法解释的大承诺更有价值。
今天就能开始的动作
从本周的重复工作里选一个,写下现有耗时、输入来源、输出标准、审核人和停止条件。不要先买工具或规定全员使用;先用这张一页试点卡,判断它是否值得进入下一轮评估。
试点结束时,把保留、调整和停止的依据一起记录下来,避免同一轮探索在不同团队反复重做。